

Transformatorių pagrįsti kalbos modeliai Apdorokite tekstą analizuodami žodžių santykius, o ne skaityti tvarka. Jie naudoja dėmesio mechanizmus, kad sutelktų dėmesį į raktinius žodžius, tačiau ilgesnio teksto tvarkymas yra sudėtingas. „SoftMax“ funkcijakuris paskirsto dėmesį, susilpnėja, kai auga įvesties dydis, todėl dėmesys išblėso. Tai sumažina modelio dėmesį į svarbius žodžius, todėl sunkiau mokytis iš ilgų tekstų. Didėjant dėmesio vertėms, detalės tampa neaiškios, todėl modelis neveiksmingas didesnėms įvestims. Jei nėra modifikuoto dėmesio mechanizmo, modelyje nėra dėmesio skiriama esminei informacijai, todėl nesugeba gerai dirbti su didesniais teksto įvestimis.
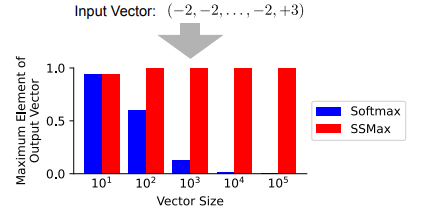
Dabartiniai metodai, skirti pagerinti ilgio apibendrinimą transformatoriuose pagrįstuose modeliuose, yra padėties kodavimas, nedidelis dėmesys, išplėstinis ilgesnių tekstų mokymas ir patobulintos dėmesio mechanizmai. Šie metodai nėra keičiami ir reikalauja daug skaičiavimo išteklių, todėl jie neveiksmingi ilgoms įvestims tvarkyti. „SoftMax“ funkcija, naudojama dėmesio pasiskirstymo metu transformatoriuose, žemina įvesties dydį. Daugiau žetonų, „SoftMax“ sukuria daugiau plokščių tikimybių pasiskirstymo, dėl kurio sumažėja raktinių žodžių akcentavimas. Toks reiškinys yra žinomas kaip dėmesio išblukimas, labai ribojantis modelio sugebėjimą apdoroti ilgą tekstą.
Siekdamas sušvelninti „Transformerių“ dėmesio išblukimą, pasiūlytas Tokijo universiteto tyrėjas „Scalable-SoftMax“ (SSMAX)kuris keičia „SoftMax“ funkciją, kad būtų galima atkreipti dėmesį į svarbius žetonus, net kai padidėja įvesties dydis. Skirtingai nuo „SoftMax“, dėl kurio dėmesys plonai plinta, augant įvestims, SSMAX Koreguoja mastelio koeficientą pagal įvesties dydį, užtikrinant, kad dominuoja didžiausia vertė. Tai išvengia dėmesio pagrindinei informacijai didesniuose kontekstuose. Ši sistema apima mastelio koeficientą, apimantį įvesties dydį, kuris keičia dėmesio apskaičiavimo formulę naudojant logaritmą. Modelis dinamiškai prisitaiko prie sutelkimo į svarbius elementus, kai variantai taikomi ir paskirsto dėmesį, kai naudojamos panašios vertės. SSMAX Lengvai integruojama į esamą architektūrą su minimaliais pakeitimais, todėl dėmesio skaičiavimui reikia tik paprasto padauginimo.
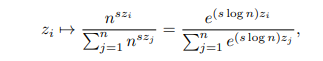
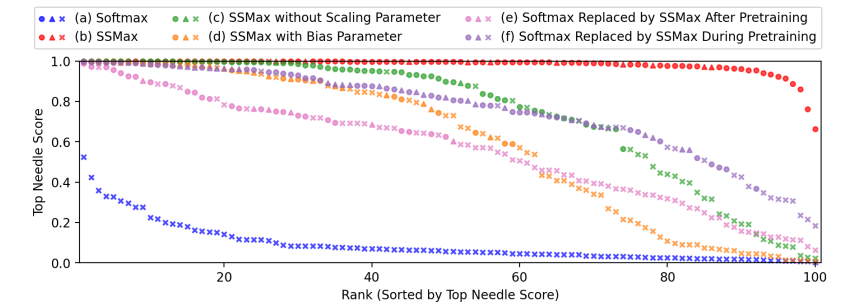
Įvertinti „SoftMax“ pakeitimo poveikį „Scalable-SoftMax“ (SSMAX) Dėmesio sluoksniuose tyrėjas atliko eksperimentus su treniruočių efektyvumu, ilgo konteksto apibendrinimu, pagrindinių informacijos gavimo ir dėmesio paskirstymo. Jie išbandė šešias konfigūracijas, įskaitant „Standard SoftMax“, SSMAX Su mastelio parametru ir be jo, „SSMAX“ su šališkumo parametru ir du modeliai, kuriuose „SoftMax“ buvo pakeistas SSMAX po išankstinio rašymo ar jo metu. „SSMAX“ nuosekliai pagerino treniruočių efektyvumą ir ilgą kontekstą apibendrinimą, sumažindamas bandymo praradimą per ilgą sekos ilgį. Adata-in-a-haystack Testas atskleidė, kad „SSMAX“ žymiai padidino pagrindinę informacijos gavimą ilgame kontekste. Tačiau pašalinant mastelio nustatymo parametrą arba pridedant skaidytą šališkumo našumą. Modeliai, kuriuose „SoftMax“ buvo pakeistas SSMAX po treniruotės ar vėlyvojo išankstinio rašymo, parodė dalinius patobulinimus, tačiau nesugebėjo atitikti visiškai apmokytų SSMAX modelių.
Apibendrinant galima pasakyti, kad šis siūlomas metodas pagerino „Transformerio“ dėmesį, kuris panaikina dėmesio išblukimą ir sustiprina ilgio apibendrinimą, todėl modeliai yra veiksmingesni atliekant ilgalaikes užduotis. Jo pritaikomumas buvo naudingas naujai apmokytiems ir esamiems modeliams, išdėstant jį kaip stiprią alternatyvą „SoftMax“. Ateitis gali optimizuoti SSMAX Siekiant efektyvumo ir integruokite jį į kylančius „Transformerių“ modelius, kad padidintumėte ilgo konteksto supratimą realaus pasaulio programose.
Patikrinkite popierius. Visas šio tyrimo kreditas skirtas šio projekto tyrėjams. Be to, nepamirškite sekti mūsų „Twitter“ ir prisijunkite prie mūsų „Telegram“ kanalas ir „LinkedIn GrOUP. Nepamirškite prisijungti prie mūsų 75K+ ml subreddit.
🚨 „MarkTechPost“ kviečia AI įmones/pradedančiuosius/grupes, kad jie galėtų partnerį už savo būsimus AI žurnalus „Atvirojo kodo AI gamyboje“ ir „Agentic AI“.
„Divyesh“ yra konsultavimo praktikantas „MarktechPost“. Jis siekia žemės ūkio ir maisto inžinerijos BTech iš Indijos technologijos instituto Kharagpur. Jis yra duomenų mokslo ir mašinų mokymosi entuziastas, norintis integruoti šias pagrindines technologijas į žemės ūkio sritį ir išspręsti iššūkius.
✅ (rekomenduojama) Prisijunkite prie mūsų telegramos kanalo